写代码的人现在有两个新问题。
一是模型调用成本,长对话、工具调用和重复修改都可能增加用量。
二是代码。公司内网的仓库、还没公开的项目、带客户数据的脚本,你不敢整段贴给云端模型。
本地模型提供了另一种选择,但过去要自己编译推理框架、找量化文件、写启动参数,折腾一晚上还不一定跑得起来。
Strata 把这一整套打包成了两个入口:一个能聊天的桌面应用,一条 strata launch 命令。
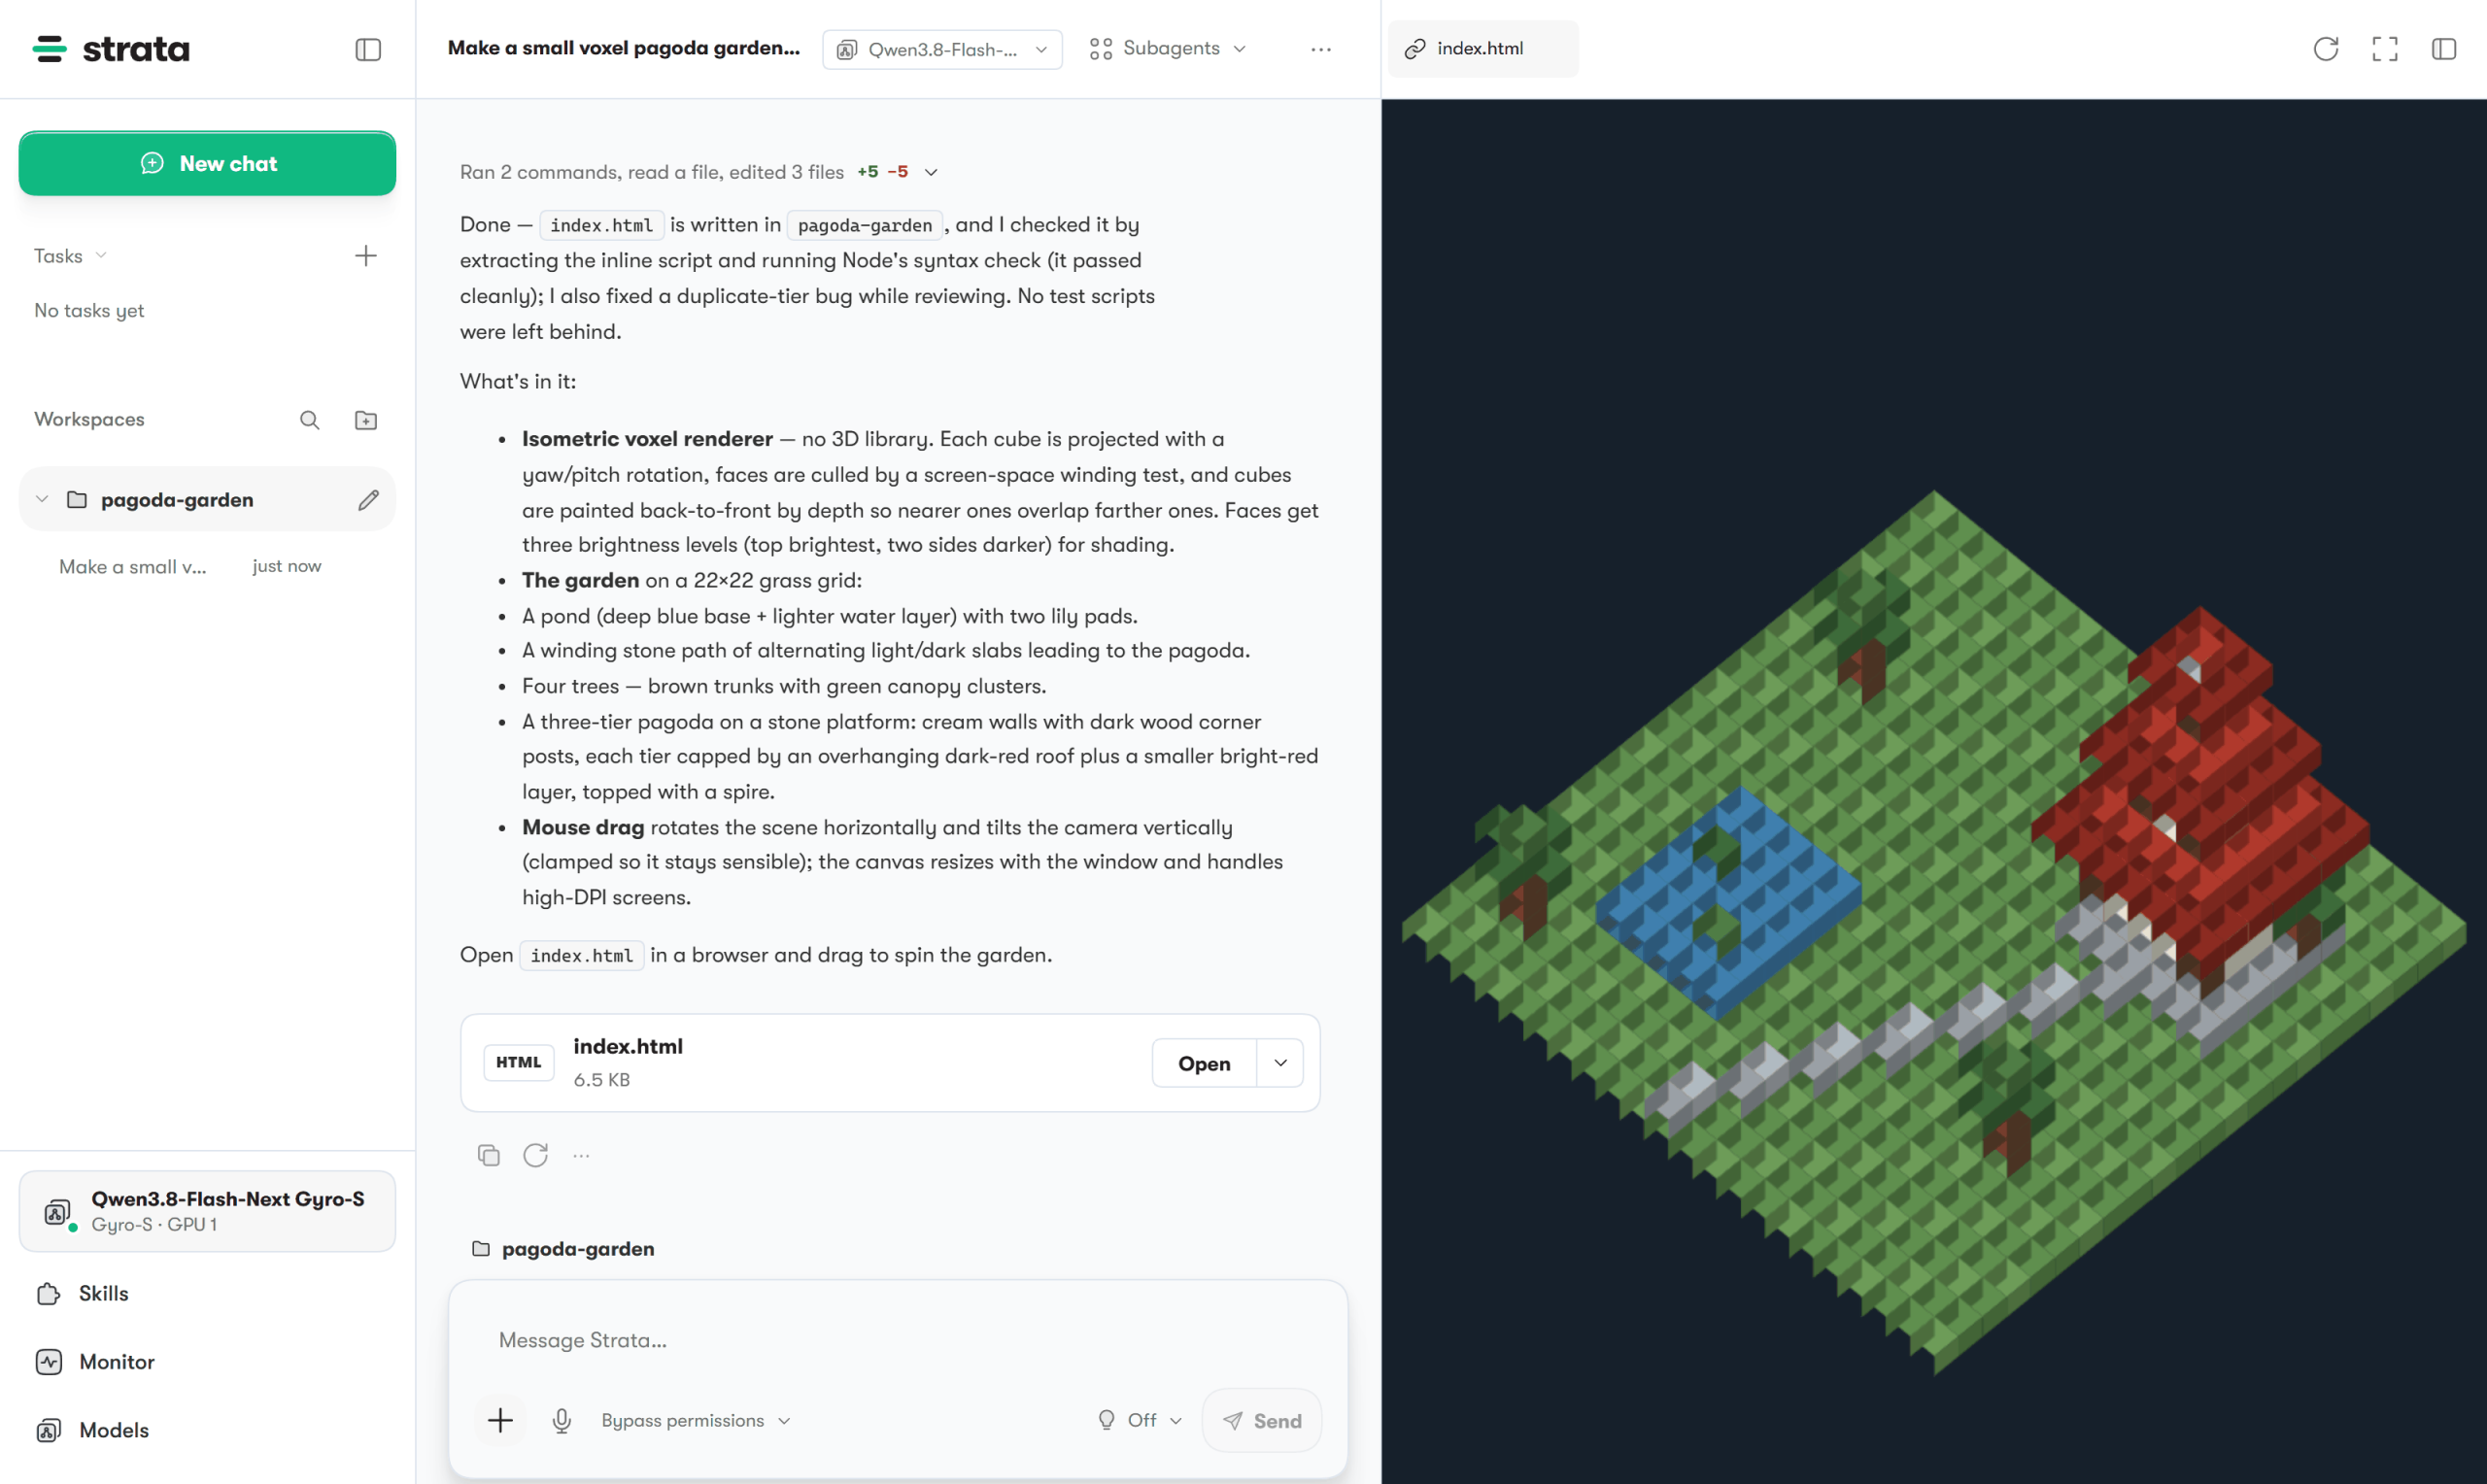
它做的事:把模型拆开,塞进你的显卡和内存
大模型不是一整块。以项目图示里的模型为例:它由 多个专家模块组成,生成内容时只激活其中一部分。
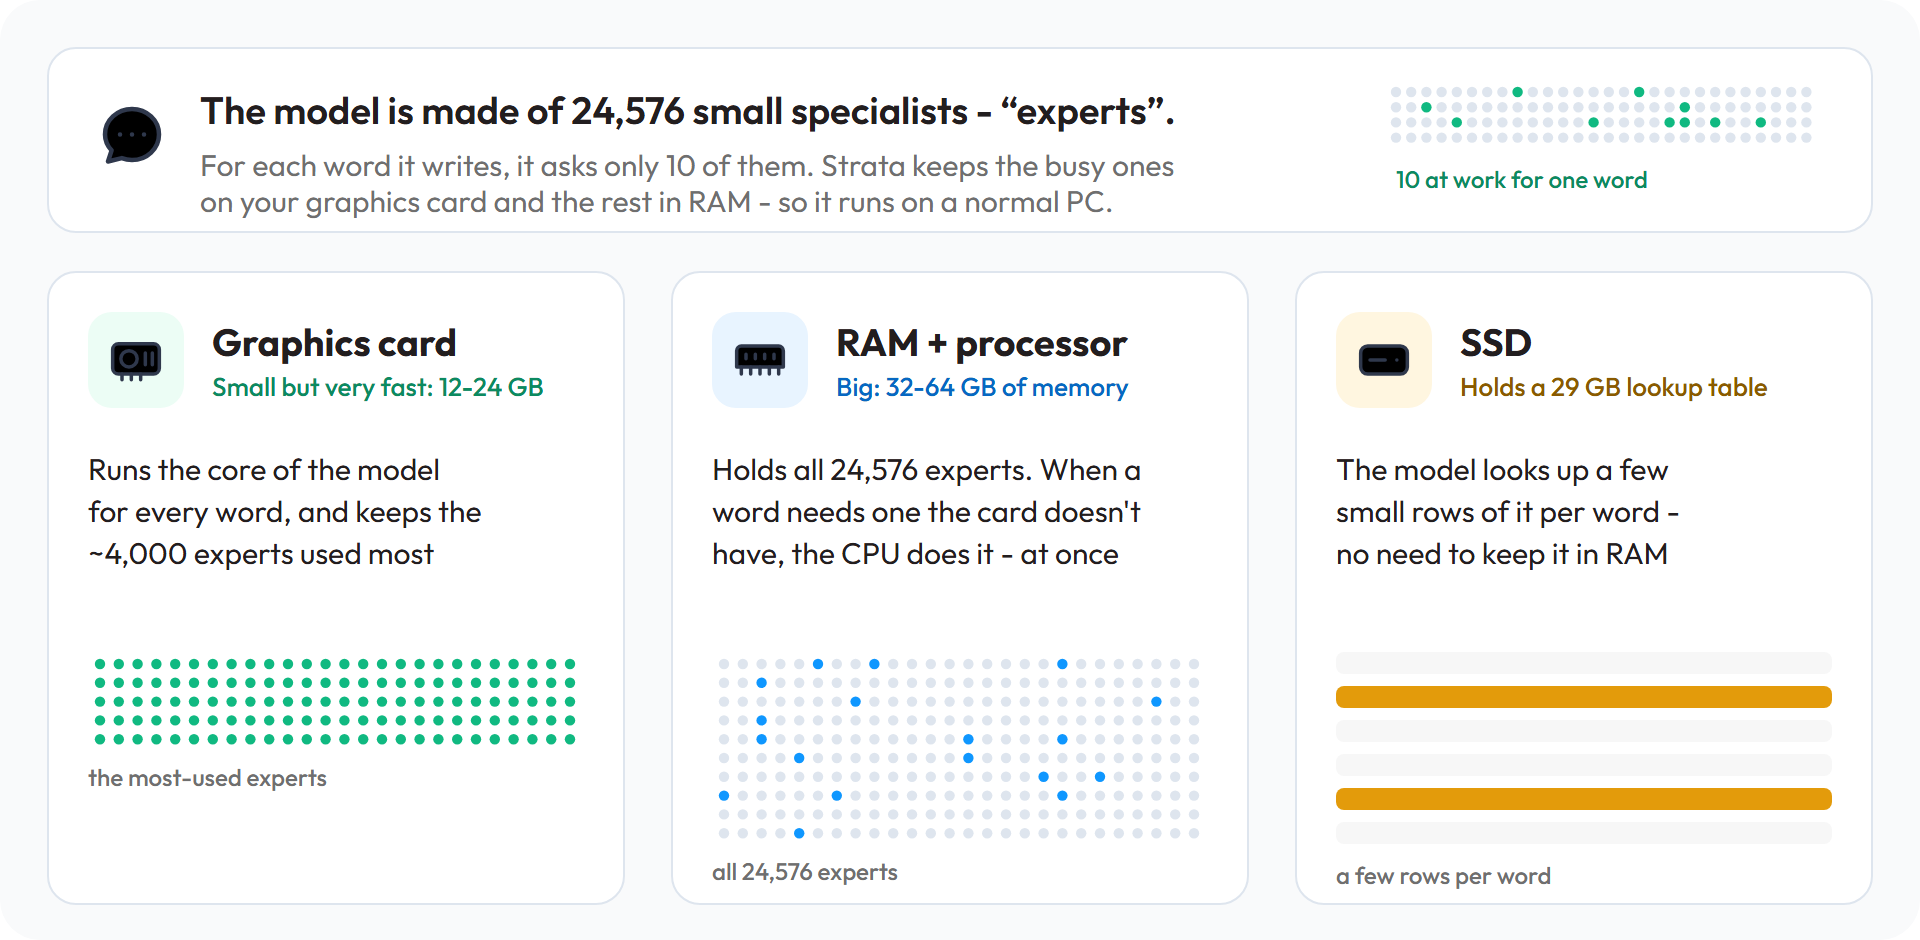
Strata 的判断是:最常用的那批专家放显卡,其余放内存,实在放不下的从 SSD 读。所以它能在普通 PC 上跑起来,而不是只认数据中心卡。
代价也在这里:模型不是「装个软件」那么轻。它要占几十 GB 内存、几十到几百 GB 磁盘,而且下载体积不等于运行时占用——项目文档专门提醒了这一点。
先看你的电脑够不够
这是全文最该先看的一段。Strata 支持这些硬件:
| 硬件 | 说明 |
|---|---|
| NVIDIA RTX 20 / 30 / 40 / 50 系 | Windows 与 Linux,CUDA 13 包要求驱动 580 以上 |
| AMD Radeon RX 7700 / 7800 / 7900、RX 9060 / 9070、AI PRO R9700 | 有对应的 HIP 包 |
| AMD RX 6800 / 6900 | 实验性支持 |
| Intel Arc | 只有 Linux,走终端,没有桌面安装包 |
| Apple Silicon(M1 及更新) | macOS 15 及以上,Intel Mac 不支持 |
| AMD Ryzen AI Max / Strix Halo | 有单独指南 |
再看模型门槛。三个模型,三种量级:
| 模型 | 内存 + 显存 | 下载体积 | 适合 |
|---|---|---|---|
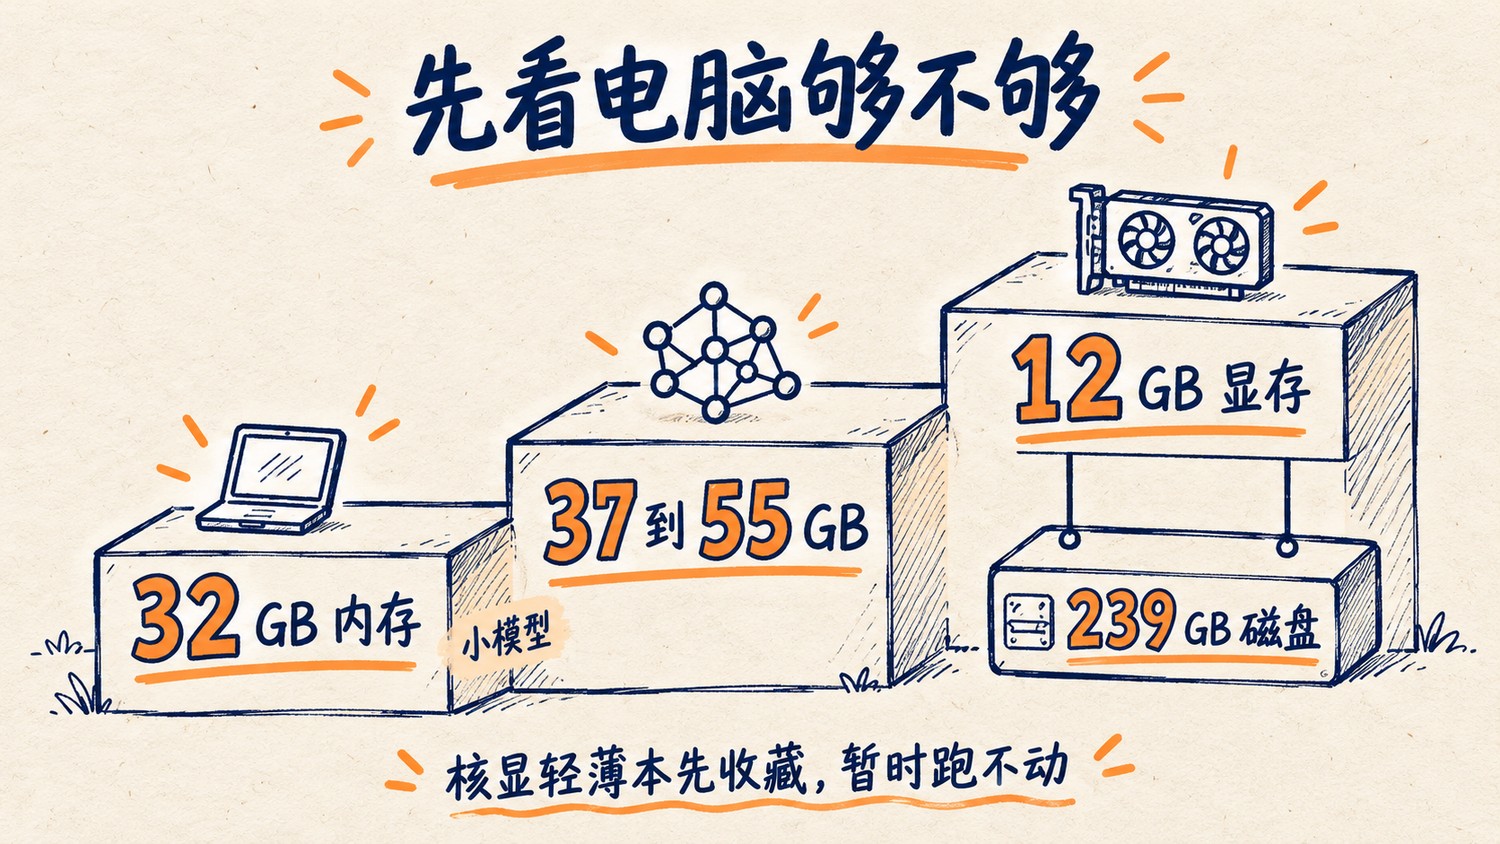
| Qwen3.6-35B-A3B | 32 GB 起 | 22.9 GB | 32 GB 内存机器的现实起点 |
| Qwen3.8-Flash-Next | 37.6 GB(Q2_0)到 54.8 GB(IQ3_S) | 几十 GB | 质量更好,门槛更高 |
| DeepSeek V4.1 Flash | 12 GB 显存 + 46 到 64 GB 内存,外加 239 到 274 GB 磁盘 | 239 GB 起 | 想在本机跑 DeepSeek,且有一块大 SSD |
这几组配置面向内存和存储较充足的机器。 内存、显存和上下文缓冲都要留余量,优先用计划预览检查。
安装:两条路,都不用管理员权限
桌面应用:从 正式版下载页 下载 Strata-0.2.6-windows-x64-setup.exe,按用户安装。安装包里没有推理引擎——第一次启动时,它会识别你的显卡,让你下载对应引擎,带进度和断点续传。
终端(更适合接编程工具):
在官方发布页获取 install.ps1,检查脚本后按安装指南执行,再打开新的终端窗口。
装完开一个新的终端窗口,然后:
strata launch
它会依次问你:用哪个模型、上下文多长、模型文件放哪、允不允许局域网访问。启动完成后打开监视器:
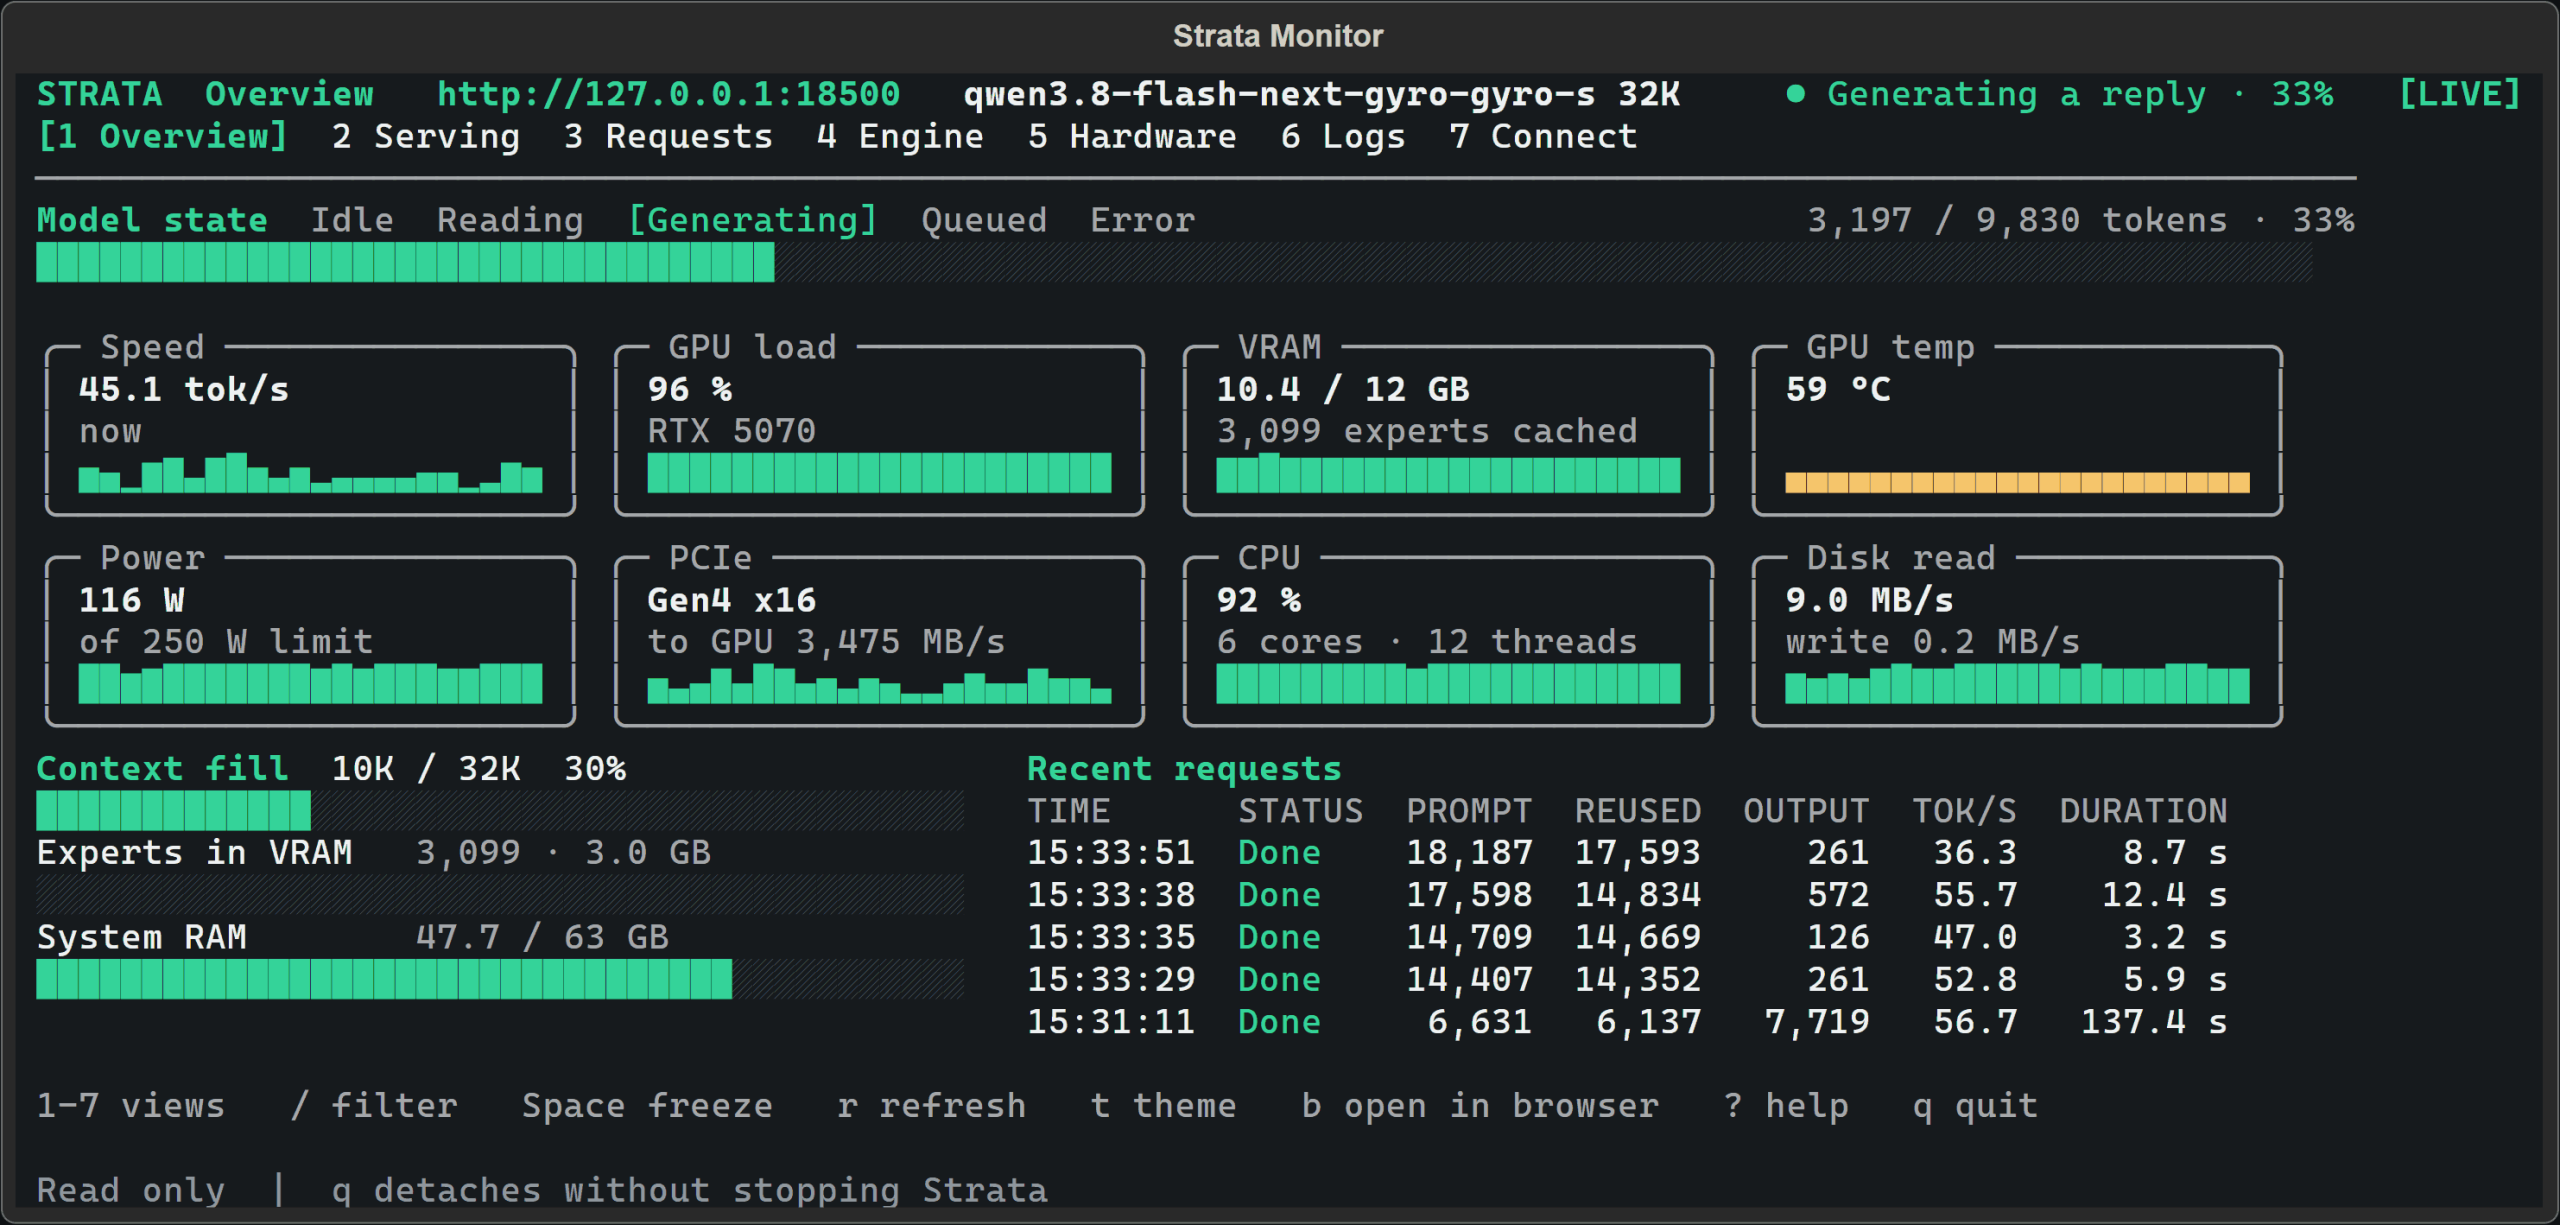
默认接口是 http://127.0.0.1:8080,只有本机能访问。
不想下载 200 GB?先看计划
--plan 只打印方案,不下载、不修改任何东西:
strata launch --family qwen --model q2_0 --plan
strata launch --family deepseek41 --model ist-das-2.00bpw --plan
确认没问题,再去掉 --plan 真正启动。已经有的模型文件也能直接用:
strata models list
strata launch --model-path D:\models\IQ3_XXS --no-tui
关键一步:把编程助手接过去
这是 Strata 和「自己搭个 llama.cpp」最大的区别。
strata connect
它会列出 OpenCode、Codex CLI、Claude Code、oh-my-pi、pi、Hermes Agent、OpenClaw 等工具,逐个给出配置文件和环境变量,地址、密钥、模型名、上下文长度都填好。下面以 OpenCode 为例(项目文档的示例就是它),换成别的工具时,名字用 strata connect 列表里显示的那个:
strata connect                    # 列出支持的工具
strata connect opencode           # 只打印配置,不改文件
strata connect opencode --write   # 写之前询问,覆盖前自动备份
strata connect opencode --check   # 发一条消息 + 一次工具调用,验证真的能用
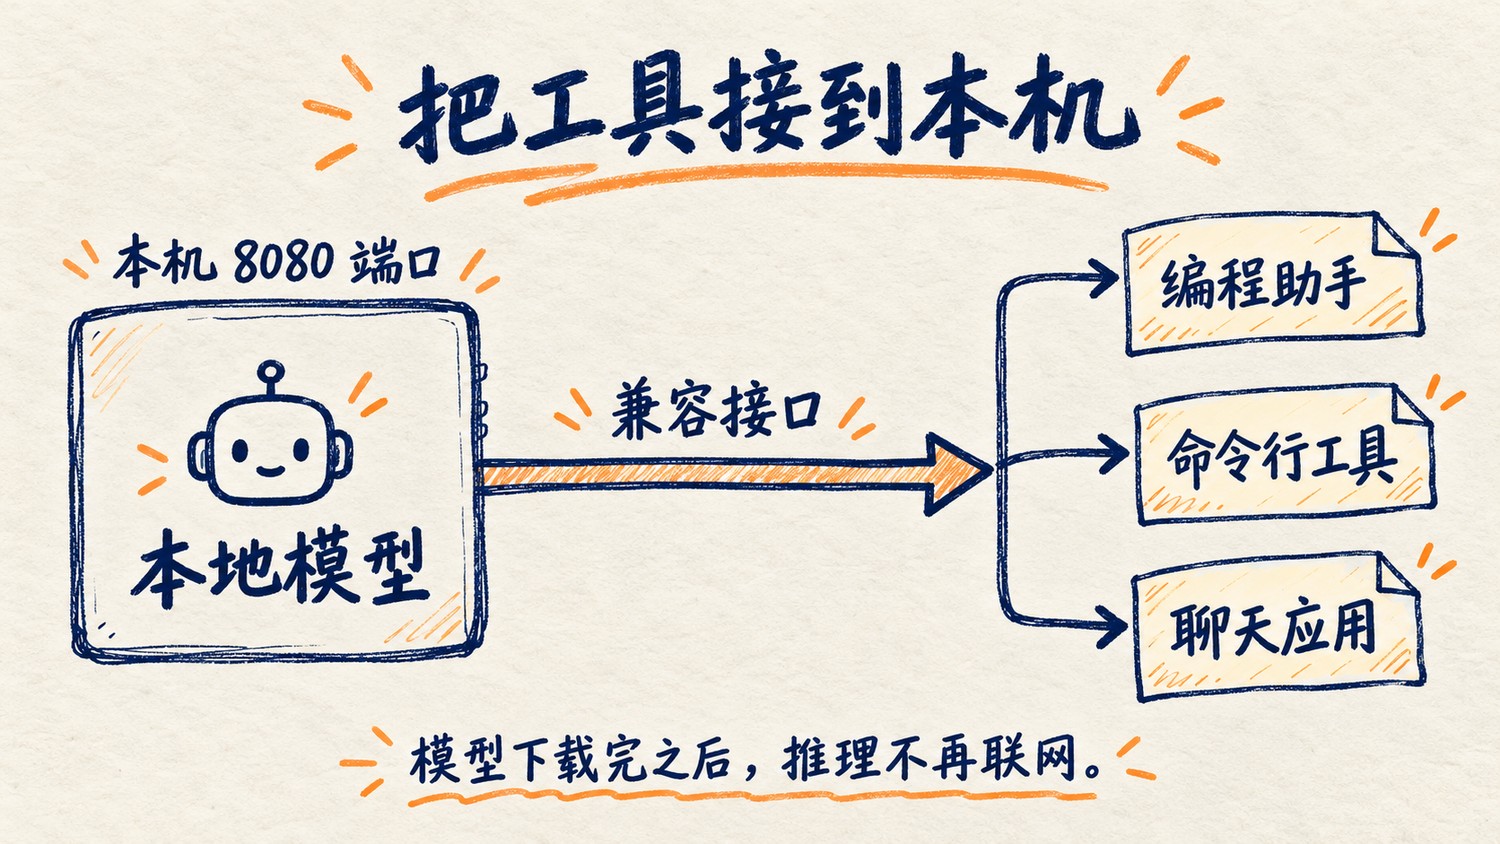
--check 这一步值得跑。它不只是「端口通不通」,而是按那个工具真实的方式发一次请求、调一次工具;加上 --output json 还能看到每一项检查的耗时和结果。
项目文档也老实写了各家的坑:Claude Code 需要设 CLAUDE_CODE_MAX_CONTEXT_TOKENS;OpenCode 要改 limit.input;Hermes 在 64K 以下上下文会拒绝;OpenClaw 要 Node 24.16 以上。
手机、平板也想用?
strata launch 的访问设置里有四档:仅本机、局域网、Cloudflare 临时隧道、Tailscale。
选局域网或隧道时,它会生成一个 API key。未启用认证时,能够访问服务端口的人可能调用模型接口——文档把这句警告写得很直白。放到公网前,key 一定要开。
速度是什么水平
以下为项目记录的 DeepSeek V4.1 Flash 2.00 bpw 测试数据,环境为 Strata 0.2.4、8K 输入长度:
| 硬件 | 输出速度 | 读入速度 |
|---|---|---|
| RTX 5070 12 GB + 64 GB 内存 | 代码输出约 5 tokens/s | 约 231 tokens/s |
| RTX 3060 12 GB + 46 GB 内存 | 6 到 9 tokens/s | 约 103 tokens/s |
这些结果不能直接当成自己电脑的预期速度。257 GB 的模型放不进 12 GB 显存时,大量数据需要通过内存和 SSD 调度,处理器、存储速度与上下文长度都会影响表现。
小一些的模型快得多。同一个 Q2_0 包,项目在 RTX 5070 上测到 94 tokens/s,在 RX 9070 XT 上测到 60 tokens/s(都是短对话)。但这些数字都来自作者的测试机,不是你的机器。
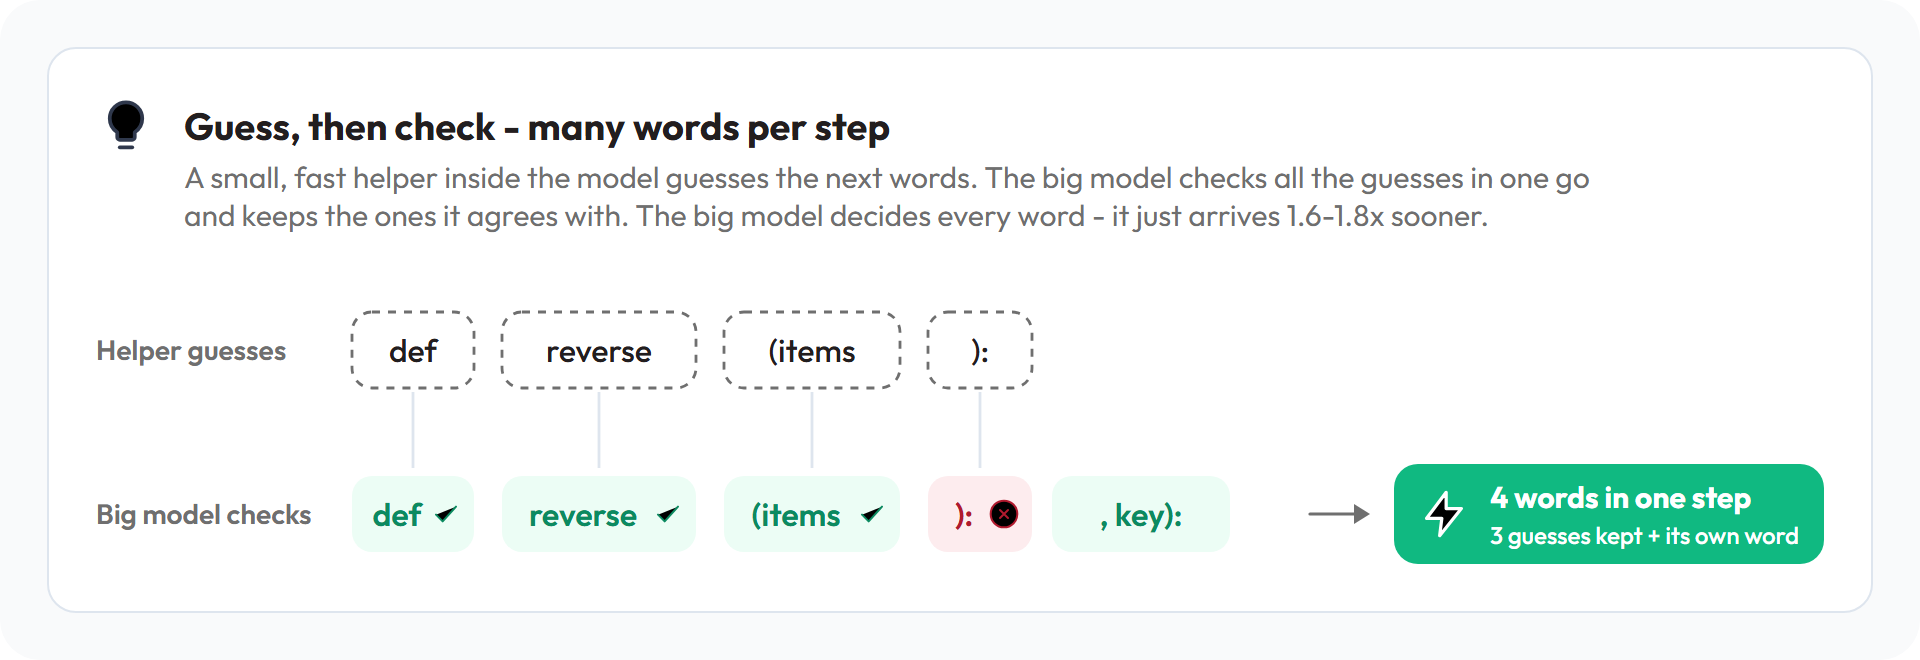
为什么能快?因为它用了投机解码:一个小模型先猜几个词,大模型一次性校验。
用之前要知道的
量化会影响结果。 更低的量化档位可以减少存储,但输出质量可能变化;不能把测试集上的困惑度差异直接当成代码正确率。应以自己的问答和工具调用任务检验。
「免费」只免 API 费。 硬件、电费、下载流量都是成本。本地推理能减少部分远程模型调用,但客户端、工具和外部服务仍可能联网,不能仅凭本地 API 就认定整个工作流完全离线。
第一次启动会很慢。 大模型文件要校验、准备、调优;调优有「快速(约 20 分钟)」和「彻底(最多 2 小时)」两档。
用实际任务判断能力。 模型、量化档位、上下文长度和硬件都会影响结果,可先从小型代码任务或日常问答开始。
它是 MIT 开源,但模型不是。 代码 MIT;模型权重和随包数据各有各的许可,用之前看 docs/HOW_IT_WORKS.md 的 credits 一节。
适合谁
适合:
- 有 RTX 20 系以上显卡、32 GB 内存以上的开发机;
- 经常用 Claude Code / Codex,想省 token 费或做离线备用;
- 代码不能出内网,需要本地模型兜底。
不适合:
- 核显轻薄本、16 GB 内存的机器;
- 只想「装个软件就能用」的人——它仍然要选模型、等下载、看日志;
- 追求最强代码能力的场景。
项目入口
- 开源仓库:github.com/Niko1221/Strata(MIT)
- 最新版本:v0.2.6,Windows / Linux / macOS 安装包与终端脚本都在 正式版下载页
- 模型与硬件指南:仓库
docs/MODELS.md、docs/INSTALL.md
想试的话,最小的一步不是下载 200 GB,而是先跑一句 strata launch --family qwen --model q2_0 --plan,看看它给你的电脑开出的清单。